如何用 AI 把图片变成可交互的粒子动画
Fan Mihua
Cross-domain Designer
从图片结构、粒子采样,到摄像头手势与麦克风吹气,一次真实项目中的方法整理。
在线预览(用电脑、谷歌):https://fanmihua.github.io/interactive-particle-experience/
这篇文章会讲清楚三件事和一个Skill
怎样把一张图片变成独立粒子;怎样用普通摄像头制造手掌靠近和擦拭的感觉;以及怎样通过真实采样,让麦克风区分吹气、说话和敲击。
同时我把粒子到感知动画,整理Skill,放在文章末尾,自行领取。
01|先决定作品要讲什么
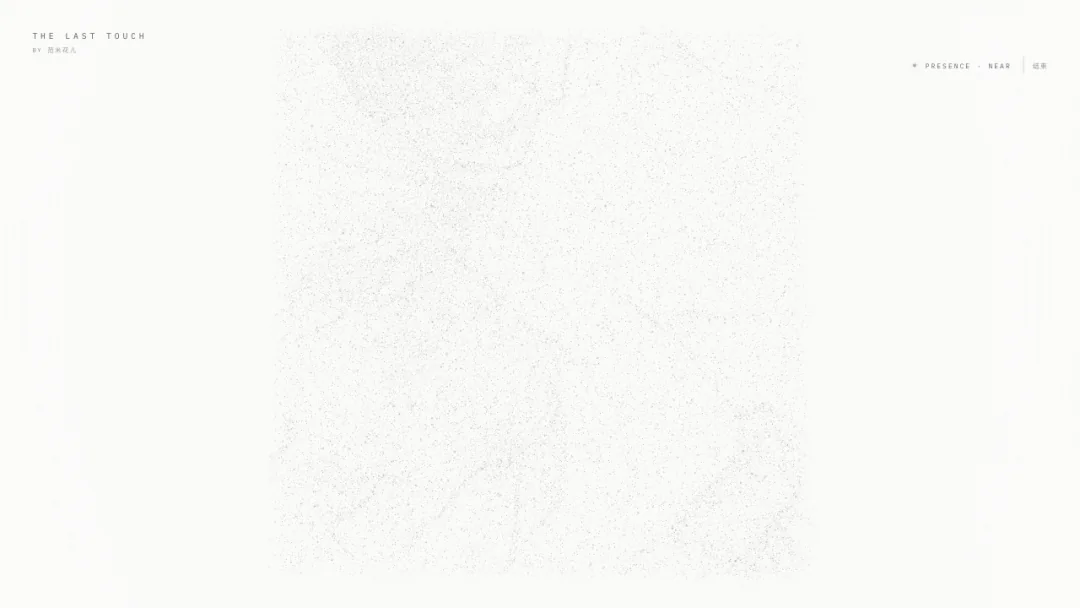
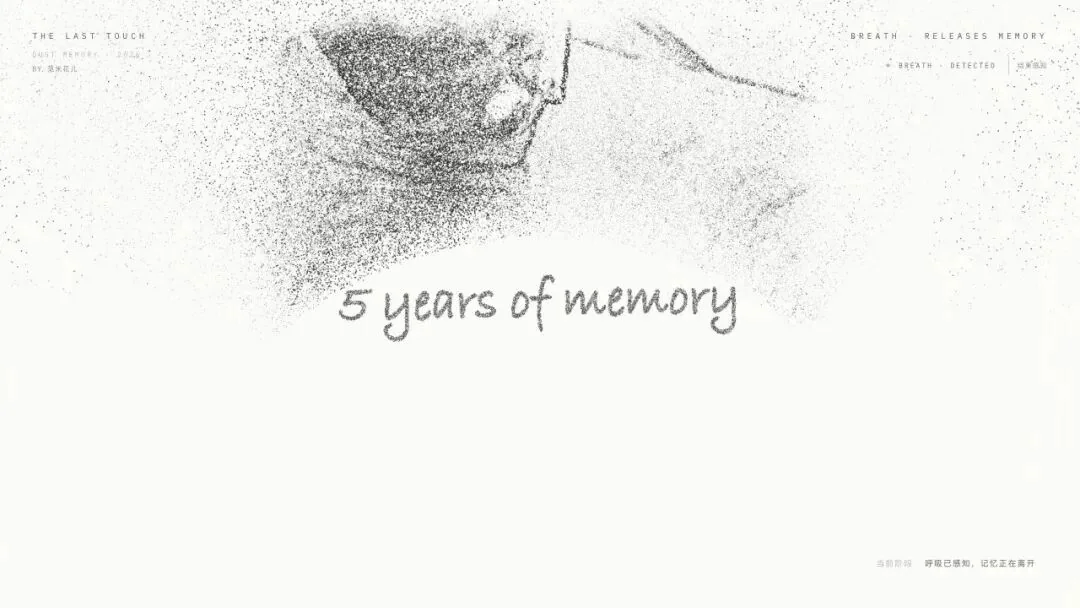
我选择了一张和奶奶握手的照片,把它设计成一段被灰尘覆盖的记忆:照片代表记忆,灰尘代表时间;人用手让画面显现,再用一口气让它离开。
我先和 AI 确定观众要经历什么:靠近时被作品注意到,伸手时留下可见痕迹,吹气时触发不可逆的结尾。摄像头、麦克风和粒子,共同完成一段体验。

你可以替换其中的素材和故事:人物照片可以表达记忆,产品图可以表达拆解与发布,Logo 可以表达聚合,海报可以变成可探索的动态视觉。
02|一张图片怎样变成粒子
先准备黑白母图,再计算结构权重,最后把被保留的位置变成粒子。
第一步:准备适合粒子的黑白母图
我没有直接把彩色原图交给采样器,而是先做黑白纪实调色。画面几何保持不变,只重新分配明暗与局部对比,让手背的褶皱、关节和两只手的边界更容易被粒子保留。
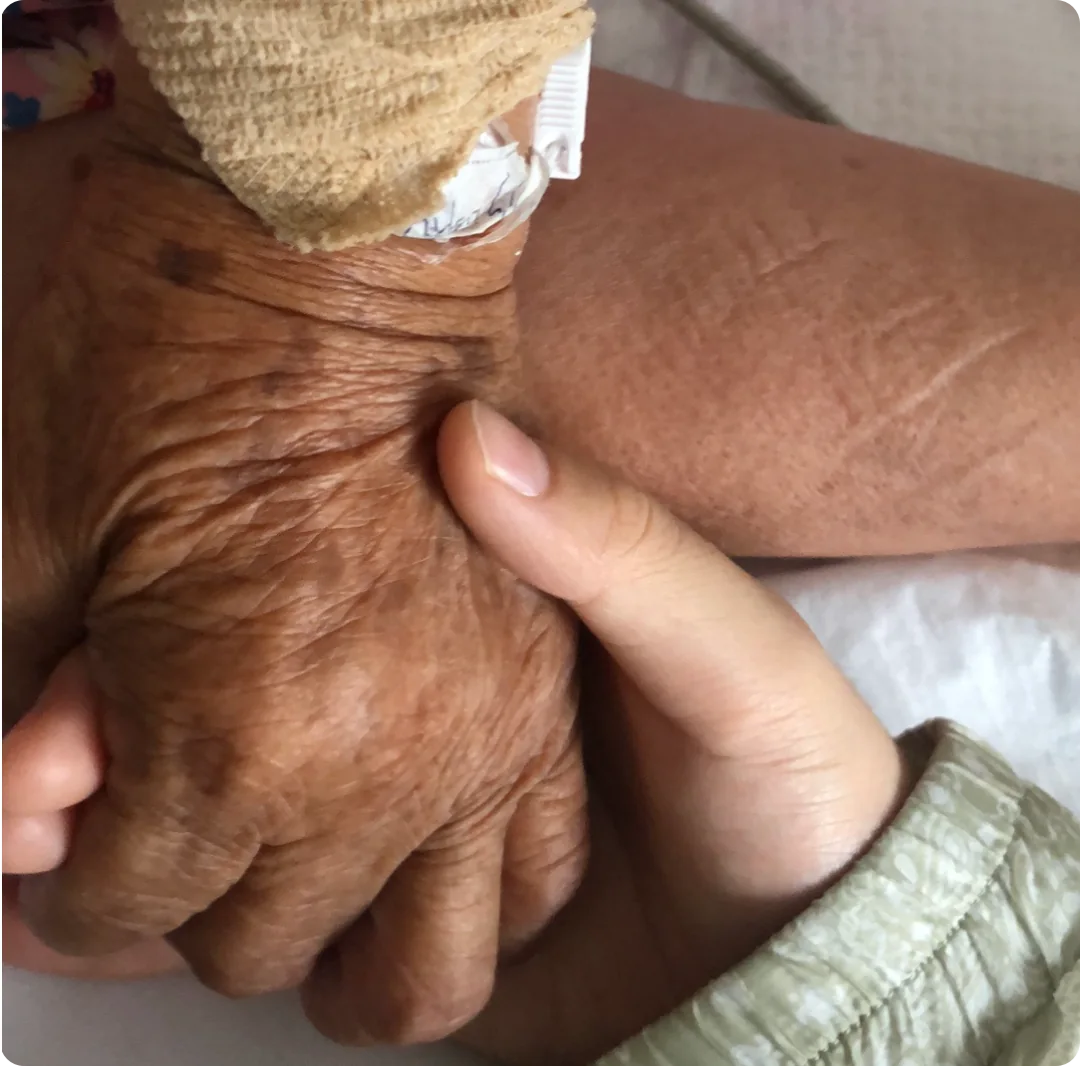
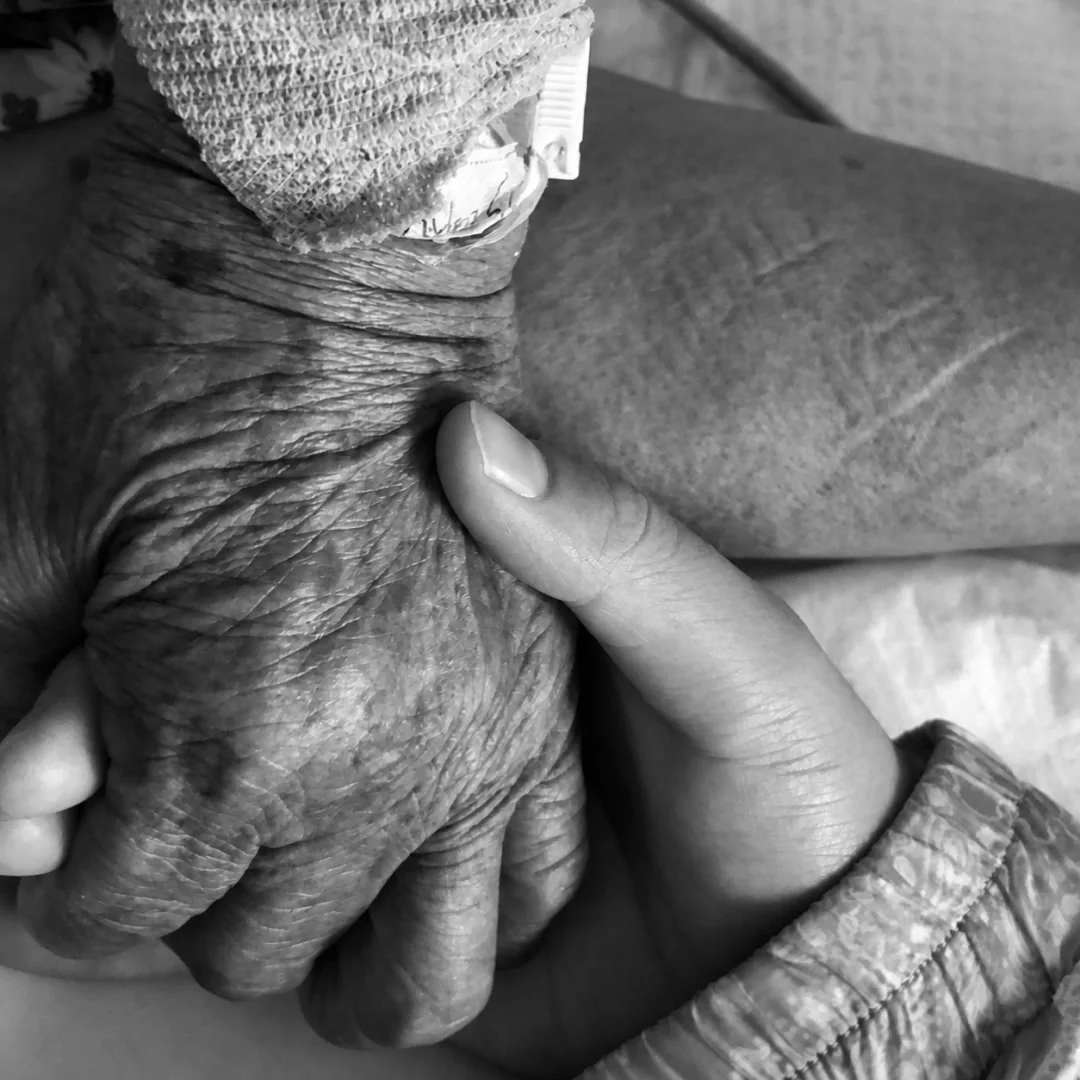
黑白处理的作用,是帮助我们判断结构,而不是制造最终效果。最优先保留的是手的外轮廓、指缝、关节转折和皮肤褶皱;宽阔而均匀的阴影,只需要少量粒子维持体积。
第二步:让代码计算结构权重
代码同时寻找外轮廓、指缝、关节转折和细小纹理。大面积平坦阴影会被降低权重,因为它虽然很暗,却不一定帮助观众认出这是一只手。
最终得到的不是普通灰度图,而是一张“哪里值得放更多粒子”的权重地图。
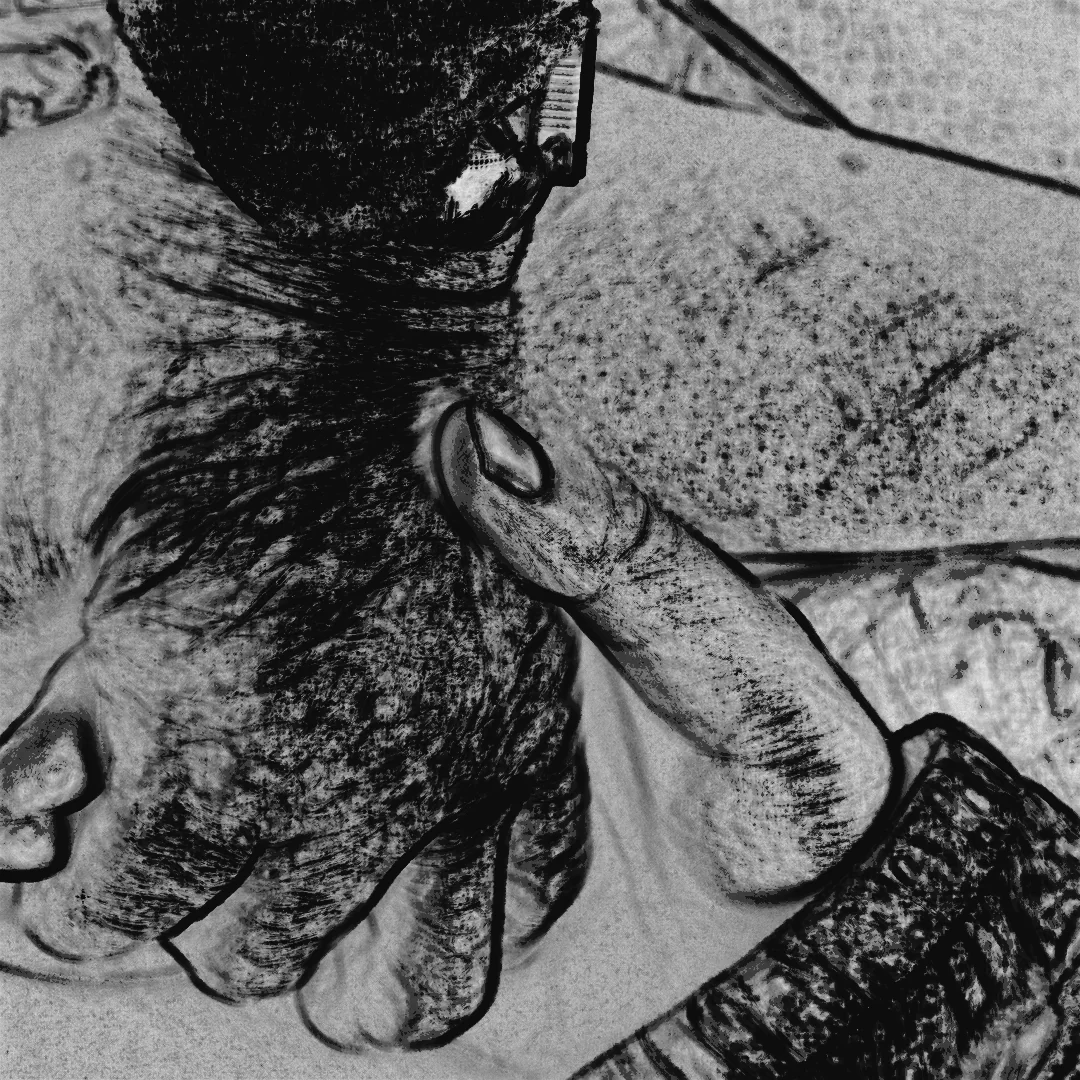
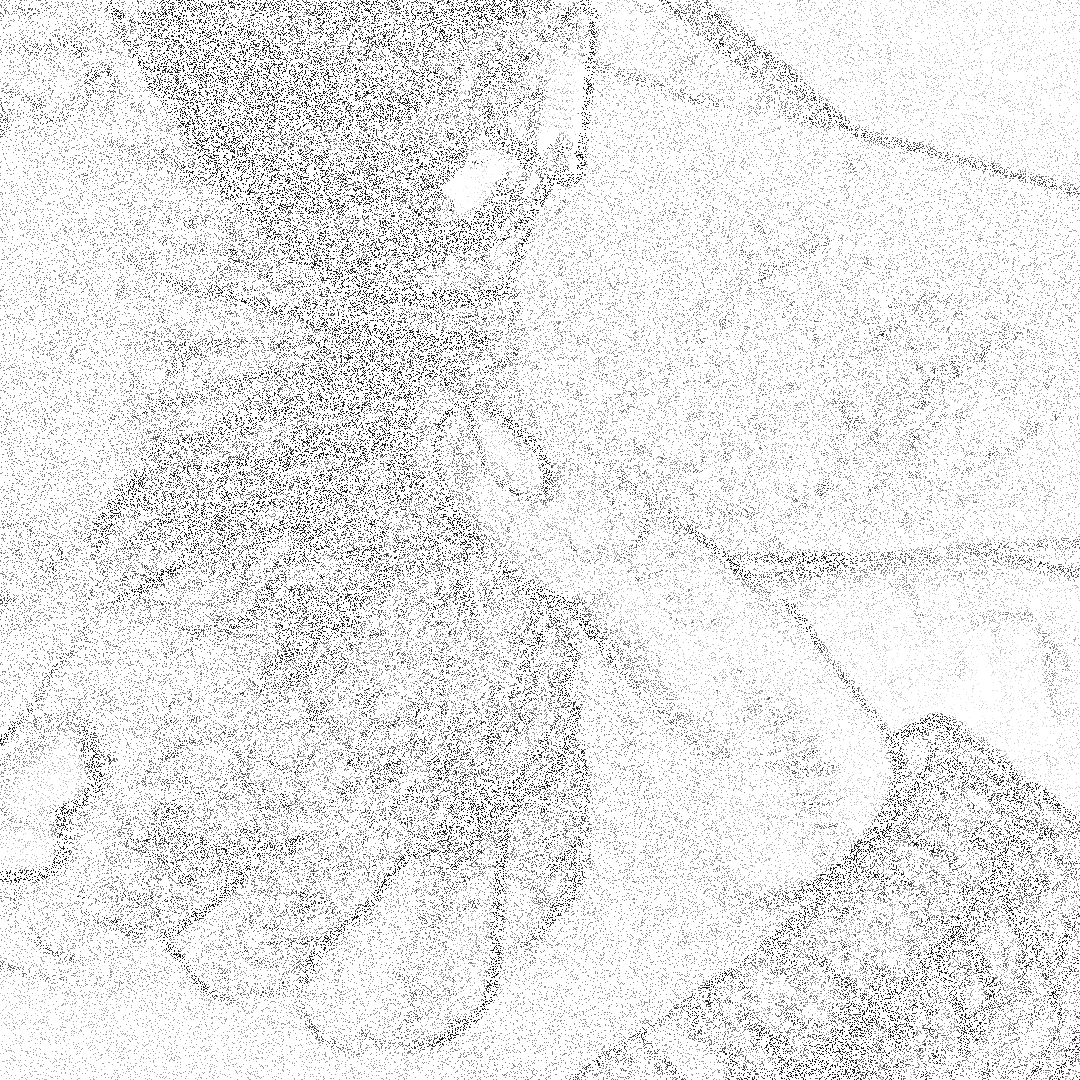
luminance → 基础密度
contour / ridge / wrinkle → 提高保留概率
keepChance → 决定这个位置是否成为粒子
程序不会把每个深色像素都同等对待,而会优先留下最能说明对象结构的位置。
第三步:把位置变成真实粒子
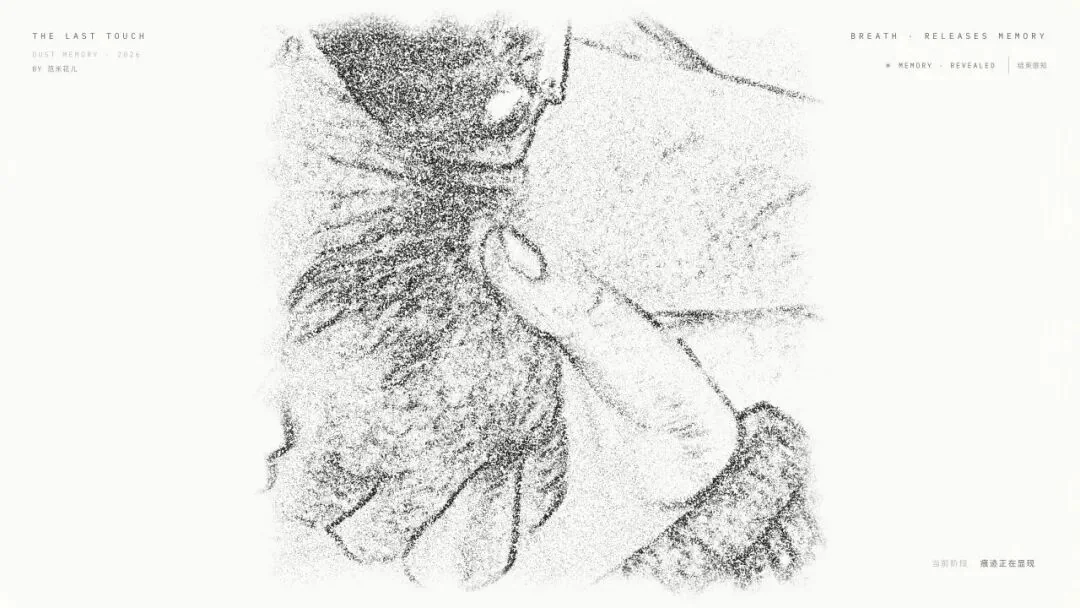
所有点进入同一个全局粒子缓冲,再拥有各自的坐标、墨色、大小和运动状态。每个点至少有三套位置:散开时从哪里来、显影时落在哪里、结束时向哪里离开。
动画真正发生在这些坐标之间,而不是整张图片做缩放或透明度变化,所以中间状态依然能看到独立粒子的运动。
03|普通摄像头怎样模拟手掌交互
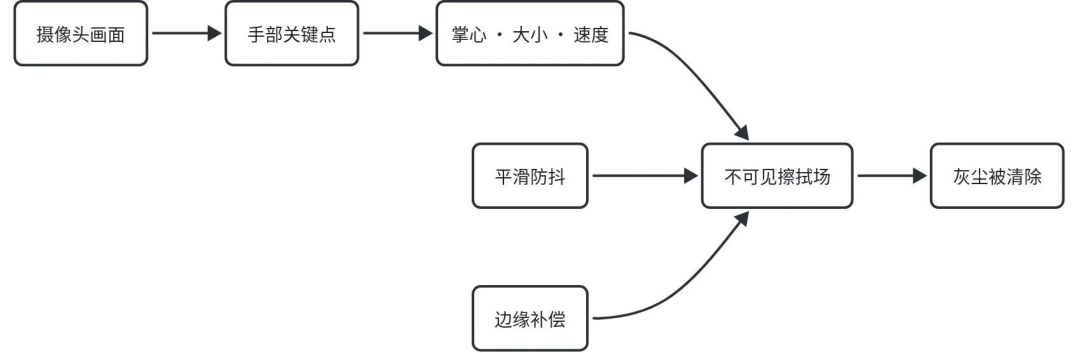
普通摄像头只能拍到连续画面。要让观众不触碰屏幕也能擦开灰尘,需要先把“手在怎么动”转换成网页可以计算的三类信号。
位置:决定灰尘从哪里被擦开。
范围:决定一次擦拭覆盖多大区域,也间接表示手正在靠近还是远离镜头。
运动:方向和速度决定擦拭路径与清除力度。
21 个关键点从哪里来
浏览器把摄像头的每一帧交给手部识别模型处理。模型会在手腕和五根手指上返回固定坐标:1 个手腕点,加上每根手指 4 个点,共 21 个关键点。
程序根据手腕和手指根部估算掌心,用最外侧点之间的距离估算手掌范围,再比较前后画面的位移得到速度。随后生成一块只参与计算的连续掌面,它不会显示成白色手形、骨架或圆形波纹。
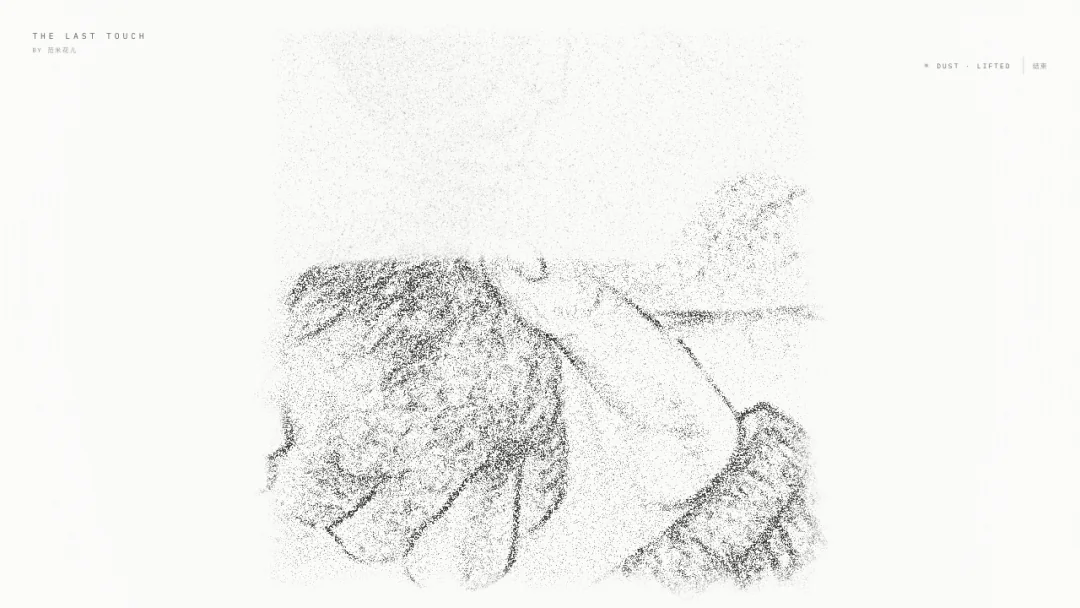
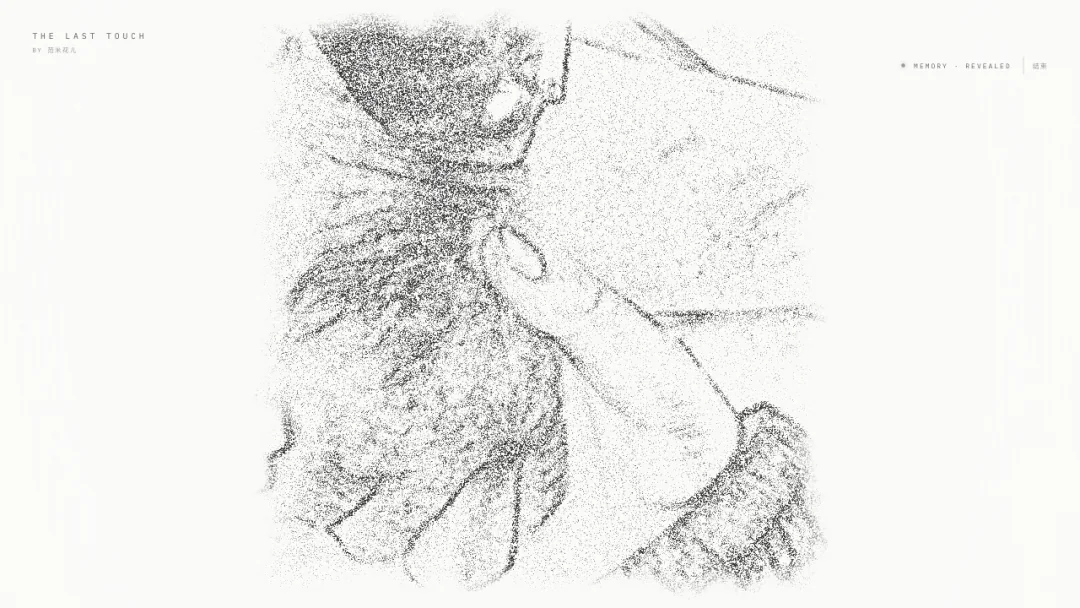
摄像头能判断的是相对变化:手更近还是更远、移动更快还是更慢。它不能测出手离屏幕的真实厘米数,但这些信息已经足够驱动交互。
最后再加入平滑和短时间确认:某一帧暂时识别不到手时,先沿用上一帧可信状态;位置与尺寸平缓跟随真实动作;已经清除的灰尘不会自动恢复。
04|麦克风怎样区分吹气、说话和敲击
吹气没有文字内容,更像持续的空气噪声。不同设备的结果不同,所以不能先猜一个阈值,而要先确认麦克风链路,再进行真实采样。
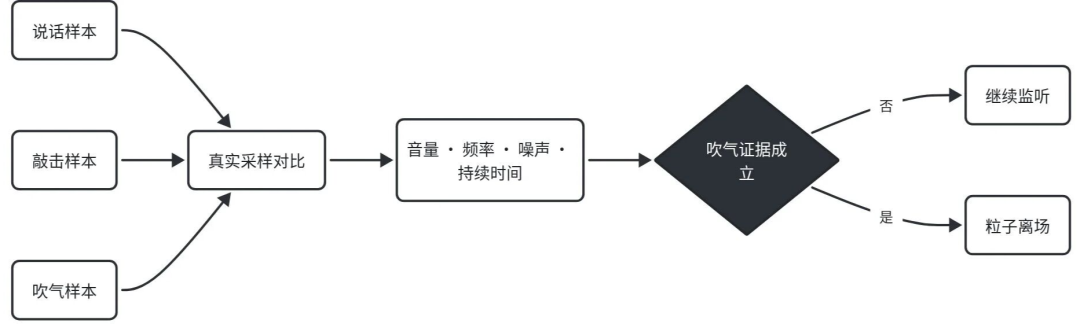
“我发现它能获取到声音,所以为什么吹气没反应?我们实时测试一下。”
我在同一台设备上采集说话、敲桌子和吹气,再比较声音强弱、频率分布、噪声感和持续时间。真正可复用的是这种对照实验,而不是某个固定阈值。
| 同设备样本 | 实测 RMS | 主要特征 |
|---|---|---|
| 持续说话 | 约 0.039 | 持续,但有明显语音结构 |
| 轻敲桌面 | 约 0.0065 | 突然而短,总体能量较低 |
| 真实吹气 | 约 0.227–0.425 | 强近场气流,低中频偏重并带噪声感 |
这些数字只属于这台 MacBook 内置麦克风,不能直接复制到所有设备。它们的价值是让我们看见差异,再建立组合判断。
程序不是依靠单一音量,而是组合声音强度、频率分布、噪声感、持续时间,以及它与环境噪声的差异。说话可能持续但更有语音结构,敲击很突然但很短,吹气则通常同时具有较强气流感和持续性。
05|从项目中可以复用的方法
无论输入是图片、摄像头、麦克风,还是未来的触摸、距离和光线传感器,都可以先走同一条路径:

1. 先找中间表示
图片先变成明暗和结构,摄像头先变成位置、大小和速度,声音先变成能量、频率和持续时间。中间表示,就是人与机器之间的翻译层。
2. 知道代理量的边界
手掌大小可以表示相对远近,却不能代表真实厘米;声音大小可以表示能量,却不能单独证明它是吹气;图片暗度可以影响粒子密度,却不能代表这个位置一定重要。
3. 无法判断时,用实验代替猜测
选择最容易混淆的几组输入,在真实设备和真实环境中采样,然后比较差异。一次只改变一个主要条件,并保留容易混淆的对照组。
4. 和 AI 沟通时,说清楚观察与目标

不必把大白话改成标准提示词。只要说明观察、问题、目标和验证方式,AI 就能继续定位需要调整的变量。
06|把方法整理成一个可按需路由的 Skill
最后,我把这套方法整理成一个统一入口:只需要说明想做图片粒子、摄像头与麦克风感知,还是两者都要,它就会选择相应流程。
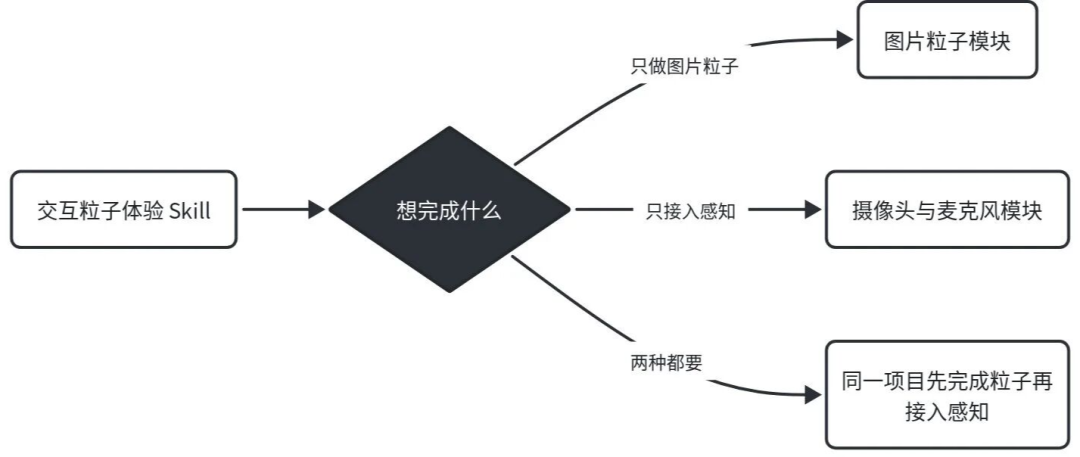
image-to-particle-page 负责黑白母图、结构采样、粒子网页和视觉自检。
camera-microphone-interaction 负责摄像头信号、麦克风采样、稳定状态、权限降级与设备检查。
这套 Skill 不是万金油!
它来自一次具体创作场景,其中的图片结构、采样方式和设备环境都有自己的条件。应用到新的作品时,仍需要根据图片层级、设备性能和实际声音环境做适配。
真正可以迁移的,是观察、采样、实验校准和真实验证的方法。
GitHub 开源仓库:interactive-particle-experience
END · 范米花儿